Visibilité
Crawlers d'IA : faut-il les bloquer dans robots.txt ?
Par François Castellani, fondateur de SIMGSOFT ·Publié le 1 septembre 2026 · Mis à jour le 18 octobre 2026 · 10 min de lecture
Réponse courte
L'essentiel de la décision
- Familles de crawlers
- 3
- Bloquer l'entraînement
- 0 perte
- Bloquer la recherche
- −citations
- Google-Extended
- ≠ Search
La question « faut-il bloquer les IA ? » est mal posée, parce qu'elle traite comme un seul sujet trois comportements qui n'ont pas du tout les mêmes conséquences sur votre visibilité.
Trois familles de crawlers, trois effets opposés
| Famille | Ce qu'elle fait | Effet si vous bloquez |
|---|---|---|
| Entraînement | Collecte du contenu pour entraîner de futurs modèles | Aucune perte de visibilité aujourd'hui |
| Recherche en direct | Indexe pour répondre et citer des sources en temps réel | Vous disparaissez des réponses citées |
| Récupération à la demande | Va chercher une page précise parce qu'un utilisateur l'a demandée | Vos pages ne s'ouvrent plus dans l'assistant |
La règle simple : bloquer l'entraînement ne coûte rien en visibilité, bloquer la recherche en direct vous retire des réponses. Ce sont deux décisions distinctes, à prendre séparément.
La liste des user-agents à connaître
| User-agent | Éditeur | Famille |
|---|---|---|
GPTBot | OpenAI | Entraînement |
OAI-SearchBot | OpenAI | Recherche en direct |
ChatGPT-User | OpenAI | À la demande |
ClaudeBot | Anthropic | Entraînement |
Claude-SearchBot | Anthropic | Recherche en direct |
Claude-User | Anthropic | À la demande |
Google-Extended | Entraînement et ancrage (Gemini) | |
Googlebot | Search + AI Overviews | |
PerplexityBot | Perplexity | Recherche en direct |
Applebot-Extended | Apple | Entraînement |
Bingbot | Microsoft | Search + Copilot |
CCBot | Common Crawl | Corpus public réutilisé pour l'entraînement |
Deux pièges classiques. Bloquer Googlebot en croyant bloquer l'IA vous sort de Google Search entièrement. Et bloquer Google-Extendedn'affecte ni votre indexation ni votre présence dans les AI Overviews : ce sont des mécanismes distincts.
Matrice de décision selon votre modèle
| Votre situation | Entraînement | Recherche en direct |
|---|---|---|
| Entreprise de services, site vitrine | Autoriser | Autoriser |
| Éditeur de logiciel, documentation publique | Autoriser | Autoriser |
| Média financé par l'abonnement | Bloquer | Autoriser |
| Base de données ou contenu sous licence | Bloquer | Bloquer les sections payantes |
| Place de marché, annonces | Bloquer | Autoriser les pages de catégorie |
| Espace client, zone authentifiée | Bloquer | Bloquer |
Pour une entreprise de services, le contenu n'est pas le produit : il sert à se faire trouver. Tout bloquer revient à payer pour écrire des guides que personne ne pourra citer.
Trois fichiers robots.txt types
Entreprise de services : tout ouvert sauf l'espace client
User-agent: *
Allow: /
Disallow: /espace-client/
Disallow: /admin/

Sitemap: https://exemple.fr/sitemap.xml
Média : refuser l'entraînement, rester citable
# Entraînement : refusé
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: CCBot
Disallow: /

# Recherche en direct et citations : autorisées
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Googlebot
Allow: /

User-agent: *
Allow: /

Sitemap: https://exemple.fr/sitemap.xml
Contenu mixte : archives ouvertes, actualité protégée
User-agent: GPTBot
Allow: /archives/
Disallow: /

User-agent: ClaudeBot
Allow: /archives/
Disallow: /

User-agent: *
Allow: /

Sitemap: https://exemple.fr/sitemap.xml
Attention à l'ordre : un groupe User-agent spécifique remplace intégralement le groupe *, il ne s'y ajoute pas. Si vous déclarez un bloc pourGPTBot, il ignore complètement les règles de *.
Cas réel : le robots.txt de ce site
Cas réel · simgsoft.com
Tout autoriser, entraînement compris, et l'écrire
Ce site suit le premier modèle ci-dessus, sans espace client à protéger : un guide de méthode a plus à gagner à être lu et cité qu'à être réservé. Les robots d'IA relèvent déjà de la règle générale, mais ils sont nommés pour que le choix soit lisible par un humain :
User-agent: *
Allow: /

# Crawlers de moteurs génératifs : autorisés volontairement.
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

Sitemap: https://simgsoft.com/sitemap.xml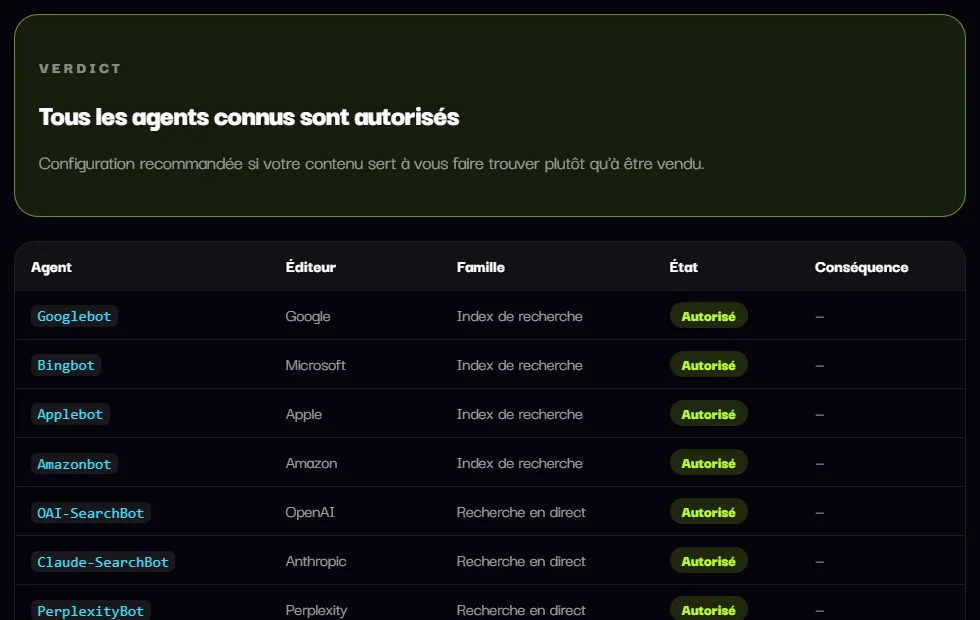
Autoriser Google-Extended ne change rien au classement dans la recherche Google : ce jeton règle seulement l'usage des contenus par les modèles de Google.
Fichier relevé le 18 octobre 2026 · fichier https://simgsoft.com/robots.txt passé dans notre vérificateur
Ce que robots.txt ne fait pas
- Il n'empêche pas l'indexation d'une page déjà connue par ailleurs. Pour retirer une page des résultats, utilisez
noindex, pasDisallow. - Il ne protège rien. C'est une convention, pas un contrôle d'accès. Ce qui est confidentiel doit être derrière une authentification.
- Il ne s'applique pas rétroactivement. Ce qui a déjà été collecté l'a été.
- Il ne remplace pas vos conditions d'utilisation, qui sont le seul terrain juridique réellement opposable.
Pour bloquer effectivement, doublez robots.txt d'une règle au niveau du serveur ou du CDN, avec vérification de l'adresse IP par résolution DNS inverse — jamais sur le seul en-tête user-agent, trivialement falsifiable.
Une fois la décision prise, l'étape suivante est de rendre vos pages citables :GEO : comment faire citer son site par ChatGPT et Perplexity. Et si vous vous demandez si llms.txt sert à quelque chose, la réponse est dans ce guide.
Sources officielles
Textes et pages officielles consultés le 18 octobre 2026.
- Overview of OpenAI Crawlers
OpenAI
Rôles de GPTBot (entraînement), OAI-SearchBot (recherche) et ChatGPT-User (actions d'utilisateur), plages IP publiées.
- Does Anthropic crawl data from the web, and how can site owners block the crawler?
Anthropic, centre d'aide Claude
Rôles de ClaudeBot, Claude-SearchBot et Claude-User, et effet du blocage de chacun.
- Perplexity Crawlers
Perplexity
PerplexityBot sert la recherche et n'alimente pas l'entraînement ; Perplexity-User ignore en général robots.txt.
- Robots d'exploration communs de Google
Google Search Central
Google-Extended couvre l'entraînement et l'ancrage Gemini, sans effet sur l'inclusion ni le classement dans Google Search.
- About Applebot
Apple
Applebot-Extended ne sert qu'à refuser l'entraînement des modèles d'Apple, sans retirer le site de la recherche.
- RFC 9309 : Robots Exclusion Protocol
IETF, RFC Editor
Sélection du groupe User-agent, repli sur le groupe *, et rappel que ces règles ne sont pas un contrôle d'accès.
- Comment Google interprète la spécification robots.txt
Google Search Central
Seul le groupe au user-agent le plus spécifique s'applique ; il n'est pas fusionné avec le groupe *.
Questions fréquentes
Non, pas directement : GPTBot collecte pour l'entraînement, il n'alimente pas les réponses citées en direct. Ce qui vous retire des réponses, c'est de bloquer les agents de recherche en temps réel comme OAI-SearchBot ou PerplexityBot. La confusion entre ces deux familles est l'erreur la plus fréquente.
Google-Extended contrôle uniquement l'utilisation de votre contenu pour entraîner les modèles Gemini et pour l'ancrage (grounding) de leurs réponses dans les applications Gemini et Vertex AI. Le bloquer n'a aucun effet sur votre indexation dans Google Search ni sur votre présence dans les AI Overviews, qui dépendent de Googlebot. C'est un curseur séparé, sans coût de visibilité.
Les principaux fournisseurs déclarent le respecter pour leurs robots d'exploration et publient leurs plages d'adresses IP pour vérification. Les agents déclenchés par un utilisateur font exception : OpenAI indique que robots.txt peut ne pas s'appliquer à ChatGPT-User, et Perplexity que Perplexity-User l'ignore en général. Ce n'est cependant qu'une convention, sans force contraignante : un acteur mal intentionné l'ignore. Pour bloquer réellement, il faut des règles au niveau du serveur ou du CDN, avec vérification de l'adresse.
Généralement non. Votre contenu n'est pas votre produit : il sert à vous faire trouver. Le calcul s'inverse pour un média dont les abonnements financent la production éditoriale, ou pour une base de données propriétaire. Dans ce cas, bloquez l'entraînement mais laissez passer la recherche en direct.
Par une résolution DNS inverse de l'adresse IP puis une résolution directe du nom obtenu, ou par comparaison avec les plages d'adresses publiées par le fournisseur. Le seul en-tête user-agent est trivialement falsifiable : ne fondez jamais une règle de sécurité dessus.
À lire ensuite
Besoin d'un avis sur votre cas ?
Décrivez votre contexte en trois lignes. On répond avec une estimation argumentée, pas un formulaire de qualification.
Poser la question →